Como fiz um Bot com os trejeitos de um amigo usando RAG, embeddings e um monte de gambiarra 29/09/2026 Tudo começou com uma brincadeira. Eu tinha um amigo que participava ativamente da nossa panelinha no Discord. Em algum momento, ele saiu do servidor e, durante uma conversa de zoeira com os amigos, surgiu uma ideia que parecia simples o bastante para valer o teste: > **E se eu fizesse um Bot que tivesse os trejeitos dele?** O problema é que eu não fazia a menor ideia de como fazer isso. Então comecei a pesquisar, testar, quebrar coisas e tentar entender como transformar um monte de mensagens antigas em algo que uma IA pudesse consultar e usar como contexto. O resultado dessa brincadeira acabou virando um pequeno laboratório sobre **scraping, embeddings, busca vetorial, RAG e modelos locais**. E este post é basicamente um registro de tudo o que aprendi no processo. ## Tecnologias utilizadas Ao longo do projeto, acabei passando por algumas tecnologias diferentes: - **Java + Spring** - **PostgreSQL + pgvector** - **MariaDB** - **RAG (Retrieval-Augmented Generation)** - **Embeddings e busca vetorial** - **Ollama** A ideia era simples: pegar as mensagens do Discord, transformar esse histórico em uma memória pesquisável e entregar para a IA o contexto necessário para ela responder de uma forma parecida com a pessoa original. Na prática, obviamente, foi um pouco mais complicado. --- # Scraper As mensagens do meu amigo estavam todas no Discord. Então, antes de pensar em IA, eu precisava primeiro conseguir **coletar os dados**. Eu já tinha mostrado aqui no blog como fazer um scraper para Discord, então essa parte não começou exatamente do zero. Mesmo assim, existia um detalhe particularmente irritante no caminho: **Rate Limit**. Raspar bastante coisa do Discord não é simplesmente mandar requisição atrás de requisição e esperar que tudo funcione. A API impõe limites, então foi necessário ter paciência, respeitar os intervalos e deixar o processo trabalhar. No final, depois de coletar todo o histórico necessário, eu tinha aproximadamente: > **94 MB de dados brutos.** 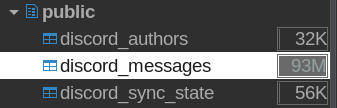 Naquele momento parecia pouco. Eu ainda não fazia ideia de quanto esse número iria crescer. --- # Hardware e vetorização Minha primeira tentativa foi usar **MariaDB**. A escolha fazia sentido naquele momento porque o banco possui suporte a vetores, que era justamente o que eu precisava para armazenar os embeddings e fazer a busca semântica. O problema apareceu quando comecei a indexar tudo. A indexação de vetores no MariaDB, da forma como eu estava utilizando, acabou se mostrando **single-thread** para o processamento que eu precisava. No meu hardware, isso tornou o processo simplesmente inviável. E o hardware do servidor também não ajudava muito. ## O humilde servidor do banco O banco de dados estava rodando em uma máquina com: - **Intel Core i3-3320** - **16 GB de RAM DDR3** - **HD WD Red de 1 TB** E eu ainda tinha exagerado em uma configuração de profundidade **16** na indexação. Foi aí que ficou evidente que não bastava escolher um banco com suporte a vetores. Eu também precisava considerar **como aquela indexação seria processada no hardware disponível**. ### Meu PC principal Meu computador principal também não era exatamente uma workstation de IA: - **Intel Core i3-8100** - **8 GB de RAM DDR4** - **SSD SATA já bem cansado** - **GTX 1060 com 6 GB de VRAM** A ideia inicial era fazer a vetorização localmente nesse PC, mas rapidamente ficou claro que o processo seria lento demais. Foi aí que entrou um elemento importante dessa história: **ajuda de amigo**. Um amigo meu, **GuilhermeDiniz**, que inclusive foi quem financiou o teste da rede Tor que mencionei aqui no blog, emprestou o arsenal computacional dele para eu conseguir rodar os testes. O que, no meu hardware, provavelmente levaria dias, nos computadores dele foi resolvido em poucas horas. Foi o suficiente para provar que o processo funcionava. Mas também serviu para mostrar outra coisa: **eu ainda não conseguiria manter tudo rodando na minha máquina**. --- # Abandonando o MariaDB Depois de apanhar um pouco dessa primeira tentativa, ficou claro que eu precisava de algo mais adequado para esse tipo de carga. Então abandonei a ideia de fazer tudo com MariaDB e migrei para uma solução mais parruda: > **PostgreSQL + pgvector** Com o PostgreSQL, eu consegui estruturar a busca vetorial de uma forma que funcionasse melhor para o meu cenário. Também precisei adaptar os embeddings ao meu hardware. Em vez de utilizar vetores maiores, defini a dimensão em apenas **384** para tentar deixar o processo mais viável na minha humilde **GTX 1060 de 6 GB**. Mesmo assim, o processo completo de vetorizar e indexar todo o histórico levou aproximadamente: > **8 horas no meu próprio hardware.** Para o contexto de uma brincadeira entre amigos, era bastante coisa. Mas funcionou. --- # De 94 MB para 1,7 GB Foi aí que apareceu uma das partes mais interessantes do projeto. Os dados originais ocupavam aproximadamente **94 MB**. Depois de gerar os embeddings e armazenar toda essa informação no banco, o tamanho total chegou a aproximadamente: > **1,7 GB.** Ou seja: uma quantidade relativamente pequena de texto bruto virou uma quantidade muito maior de dados quando passei a armazenar também as representações vetoriais necessárias para a busca semântica. Esse foi um dos momentos em que ficou bem claro que trabalhar com IA não é apenas uma questão de "mandar texto para o modelo". Existe toda uma camada de infraestrutura por trás disso. --- # RAG Depois de toda a parte de scraping, embeddings, banco de dados e indexação, chegou a etapa que eu inicialmente achei que seria a mais complicada. Na prática, foi uma das partes mais simples. O funcionamento básico ficou mais ou menos assim: 1. O usuário faz uma pergunta. 2. A pergunta é enviada para a IA para ser **limpa e transformada em palavras-chave**, melhorando a busca pelo contexto. 3. O resultado dessa transformação é **vetorizado**. 4. Esse vetor é usado para pesquisar no banco de dados. 5. Os resultados encontrados são enviados novamente para a IA junto com o prompt original. 6. A IA usa esse contexto para montar a resposta. Isso é, de forma simplificada, o coração do **RAG (Retrieval-Augmented Generation)**. A IA não precisa memorizar todo o histórico do Discord dentro do próprio modelo. Ela pode consultar uma memória externa, recuperar os trechos relevantes e utilizá-los na hora de responder. --- # E onde entram os trejeitos? A parte mais divertida vem justamente aqui. Depois de recuperar os contextos relevantes, eu posso montar um prompt pedindo para a IA assumir um determinado comportamento. Por exemplo, ela pode ser tratada como **um usuário específico** ou simplesmente receber a instrução de **fingir ser determinada pessoa**, usando os textos recuperados como referência. Na prática, o banco não está armazenando a "personalidade" da pessoa de forma mágica. Ele está armazenando **informações e exemplos de como aquela pessoa escrevia**. O RAG recupera os exemplos mais relevantes e entrega esse material para o modelo. A partir daí, o modelo tenta produzir uma resposta coerente com aquele contexto. É aí que a brincadeira começa a ficar interessante. --- # O resultado Depois de toda a gambiarra, o resultado ficou **ridiculamente rápido**, mesmo utilizando um hardware bastante modesto. O motivo principal é que eu não estava tentando consultar todo o histórico do Discord a cada pergunta. A informação já estava **vetorizada e indexada no banco**, então a aplicação conseguia encontrar rapidamente os contextos semanticamente mais próximos da pergunta. Isso transformou um problema que inicialmente parecia exigir uma máquina muito mais forte em algo que eu conseguia executar no meu próprio computador. O preço foi o tempo necessário para preparar tudo. Foram horas coletando mensagens, gerando embeddings, indexando vetores, trocando de banco e ajustando o processo até encontrar uma configuração que o meu hardware conseguisse suportar. Mas, depois que tudo estava pronto, a experiência de uso era outra história. --- # O que começou como uma zoeira No fim das contas, tudo isso nasceu de uma ideia extremamente idiota: > **"E se eu fizer um bot que fala igual ao meu amigo?"** E, como costuma acontecer com projetos desse tipo, a brincadeira acabou me obrigando a aprender uma quantidade absurda de coisas que eu não pretendia estudar naquele momento. No processo, passei por **scraping de Discord, Rate Limit, embeddings, vetores, indexação, MariaDB, PostgreSQL, pgvector, RAG e modelos locais com Ollama**. E a parte mais curiosa é que a tecnologia toda funciona muito bem quando você separa os problemas: - o scraper coleta os dados; - os embeddings transformam texto em vetores; - o banco armazena e indexa esses vetores; - o RAG recupera o contexto relevante; - e o modelo usa esse contexto para gerar a resposta. No final, eu só queria fazer uma cópia virtual de um amigo para continuar a zoeira. Acabei montando, sem querer, um pequeno sistema de memória semântica para IA. Nada mal para uma baguncinha no Discord.